

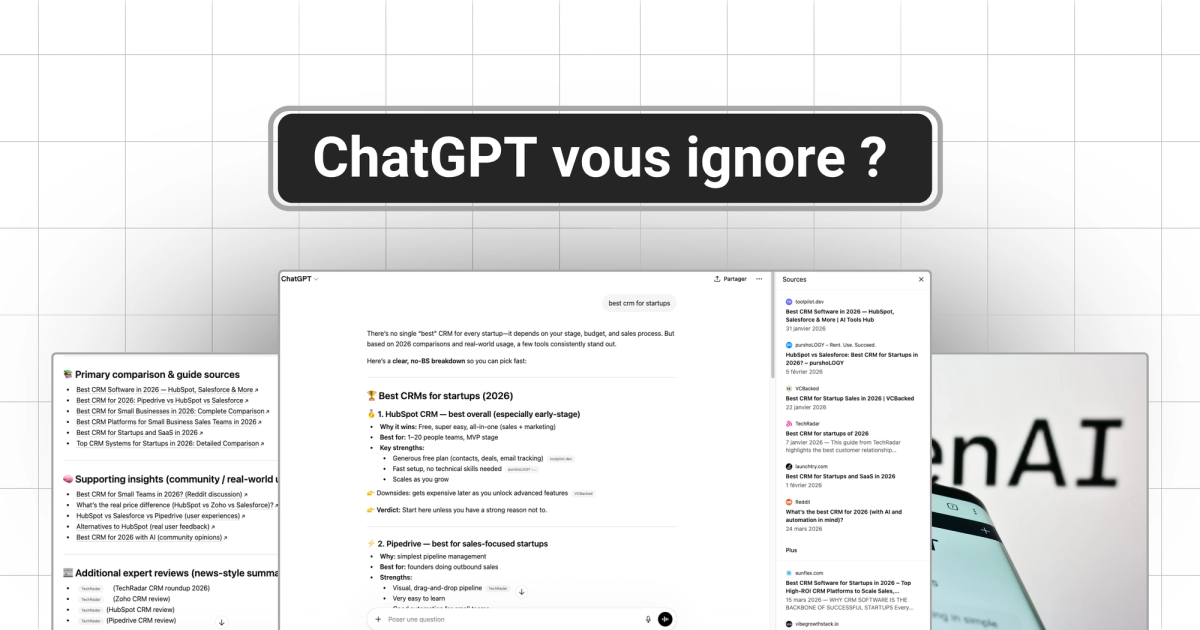
Vous avez déjà tapé une question sur votre secteur dans ChatGPT et regardé les résultats avec une certaine inquiétude. Votre concurrent est là, en première position, décrit comme la référence du marché. Vous n'êtes pas mentionné. Ou alors vous l'êtes, en bas, avec une phrase vague qui ne donne pas envie de cliquer.
La première question qui vient, c'est : pourquoi eux et pas moi ? Qu'est-ce qu'ils ont fait que je n'ai pas fait ?
La réponse est moins mystérieuse qu'il n'y paraît. ChatGPT ne fait pas de favoritisme. Il suit une logique précise, avec des signaux identifiables. Et une fois que vous comprenez cette logique, vous pouvez travailler dessus.
D'abord, comprendre ce que ChatGPT est vraiment
ChatGPT n'est pas un moteur de recherche. Il ne crawle pas le web en temps réel pour répondre à votre question (sauf en mode navigation activé). Il est un modèle de langage entraîné sur des milliards de textes jusqu'à une date de coupure.
Concrètement : tout ce que ChatGPT sait sur votre marque, il l'a appris pendant sa phase d'entraînement. Articles de blog, forums, comparatifs, fiches produits, discussions Reddit, avis clients, newsletters, documentation. Tout ce qui était accessible en ligne et qui a été inclus dans ses données.
Quand vous lui posez une question sur votre catégorie, il ne va pas chercher. Il synthétise ce qu'il a déjà appris. Et si ce qu'il a appris sur vous est flou, incomplet ou contradictoire, il vous mentionne peu ou mal.
ChatGPT ne cherche pas qui est le meilleur. Il dit ce qu'il sait avec le plus de confiance. Et la confiance se construit sur la cohérence et le volume des signaux qu'il a reçus.
Les deux modes de fonctionnement : training data et RAG
Il faut distinguer deux situations très différentes.
ChatGPT en mode standard : la mémoire figée
Sans navigation activée, ChatGPT puise uniquement dans ses données d'entraînement. C'est une photo du web à une date donnée. Si votre marque n'existait pas ou n'était pas suffisamment présente en ligne avant cette date de coupure, vous êtes dans l'angle mort du modèle.
C'est aussi pour ça que des marques fondées depuis 2 ou 3 ans peuvent avoir une visibilité faible sur ChatGPT standard : elles sont trop récentes par rapport aux dernières données d'entraînement du modèle.
ChatGPT avec navigation (et les moteurs RAG) : le web en temps réel
Quand ChatGPT est en mode navigation, et c'est le mode que Perplexity utilise par défaut, le modèle effectue des recherches en temps réel sur le web avant de formuler sa réponse. C'est ce qu'on appelle le RAG, pour Retrieval-Augmented Generation.
Dans ce mode, un article publié hier peut déjà influencer la réponse d'aujourd'hui. La fraîcheur de votre contenu, sa structure, et sa crawlabilité deviennent des facteurs directs de visibilité.
Les 4 types de sources que ChatGPT privilégie
Que ce soit dans ses données d'entraînement ou via le RAG, ChatGPT ne traite pas toutes les sources de la même façon. Certains types de contenu pèsent structurellement plus que d'autres.
1. Les contenus éditoriaux structurés
Les articles de blog bien structurés, avec des titres H2/H3 clairs, des listes, et des réponses directes aux questions, sont exactement le format que les LLM apprennent à citer. Si votre article répond mieux que quiconque à "comment mesurer sa visibilité IA", c'est lui que le modèle va réutiliser comme référence sur ce sujet.
2. Les sources d'avis et de comparaisons
G2, Capterra, Trustpilot, Product Hunt. Ces plateformes sont massivement incluses dans les données d'entraînement des LLM. Un profil G2 complet avec des dizaines d'avis détaillés est une source que le modèle considère comme fiable et représentative. Les avis qui décrivent précisément ce que fait votre outil sont particulièrement précieux.
3. Les discussions communautaires
Reddit est crawlé massivement par Perplexity et était très présent dans les données d'entraînement de GPT. Une discussion dans r/SEO ou r/SaaS où quelqu'un recommande votre outil dans un contexte authentique vaut souvent plus qu'un article optimisé sur un blog de faible autorité. La raison : le modèle interprète les recommandations spontanées entre utilisateurs comme des signaux de confiance élevée.
4. Les mentions dans des contenus éditoriaux de référence
Un article dans une newsletter SEO lue par 20 000 professionnels, un guide publié sur un blog d'autorité dans votre secteur, une mention dans un article de presse spécialisée : ces contenus sont sur-représentés dans les données d'entraînement parce qu'ils ont eux-mêmes beaucoup de lecteurs, de partages, et de liens entrants.
Ce que ChatGPT lit quand il vous cherche
Voici quelque chose que beaucoup ignorent : quand ChatGPT construit sa représentation de votre marque, il ne lit pas juste votre site. Il lit tout ce que le web dit de vous.
Votre page d'accueil, bien sûr. Mais aussi la façon dont vous vous décrivez sur LinkedIn, votre fiche Crunchbase, les avis sur G2, les articles qui vous comparent à vos concurrents, les threads Reddit où des utilisateurs parlent de votre outil, les newsletters qui vous ont mentionné, et même les réponses que vous avez données à des avis négatifs.
Le modèle agrège tout ça et en tire une représentation synthétique. Si 30 sources différentes décrivent Vizible AI comme "un outil de suivi de visibilité dans les LLM pour équipes B2B", le modèle a une image claire et confiante de ce que vous êtes. Si chaque source utilise une formulation différente, l'image est floue.
Les signaux concrets qui font qu'une marque est citée
En pratique, cinq facteurs déterminent si vous apparaissez dans les réponses ChatGPT sur votre catégorie.
La fréquence de mention. Plus votre marque est mentionnée dans des sources variées et crédibles, plus le modèle la considère comme une réponse valide à une question sur votre catégorie. C'est la base.
La cohérence de la description. Si vous vous décrivez comme "plateforme d'analytics IA" sur votre site, "outil de monitoring LLM" sur LinkedIn, et "solution GEO" sur G2, le modèle a trois entités partiellement différentes. Moins de cohérence, moins de confiance dans la citation.
La qualité du contenu propre. Vos articles de blog, vos pages produits, votre documentation. Si ce contenu répond directement aux questions que les utilisateurs posent à ChatGPT, le modèle va s'en servir comme source de réponse.
L'ancienneté et le volume de la présence en ligne. Une marque présente depuis 5 ans avec des centaines de mentions a une empreinte dans les données d'entraînement bien plus forte qu'une marque de 18 mois. Ce n'est pas une fatalité, mais c'est une réalité à travailler activement.
La crawlabilité de votre site. Pour ChatGPT en mode navigation et Perplexity, si vos bots IA (GPTBot, PerplexityBot) sont bloqués dans votre robots.txt ou si vos pages sont trop lentes, votre contenu n'est tout simplement pas lu. Le meilleur article du monde n'a aucune valeur s'il ne peut pas être crawlé.
Ce que vous pouvez contrôler, et ce que vous ne pouvez pas
Soyons honnêtes sur ce qui est en votre pouvoir et ce qui ne l'est pas.
Ce que vous contrôlez totalement
La clarté et la cohérence de votre description sur toutes les plateformes
La qualité et la profondeur de votre contenu éditorial
La crawlabilité de votre site (robots.txt, vitesse de chargement, HTML statique)
La complétude de vos profils sur G2, Capterra, Crunchbase, Product Hunt
La cadence de publication de nouveaux contenus
Ce que vous influencez indirectement
Les mentions dans des sources tierces (newsletters, articles comparatifs, presse)
Les discussions organiques sur Reddit et les forums
Les avis clients sur les plateformes tierces
Ce que vous ne contrôlez pas
La date du prochain cycle d'entraînement de ChatGPT
Les pondérations internes du modèle pour chaque type de source
Le fait qu'un concurrent publie un contenu particulièrement fort ce mois-ci
Perplexity fait différemment, et c'est important
Perplexity est souvent traité comme une alternative à ChatGPT, mais son fonctionnement est fondamentalement différent. Perplexity utilise le RAG par défaut : à chaque réponse, il cherche sur le web en temps réel, lit les pages, et synthétise ce qu'il trouve avec des citations de sources.
Ce qui signifie : un article que vous publiez aujourd'hui peut apparaître dans une réponse Perplexity demain. Le délai entre action et effet est de quelques jours, pas de quelques mois. C'est pour ça que Perplexity est souvent le premier moteur où les stratégies GEO commencent à porter leurs fruits.
Pour Perplexity, les facteurs les plus importants sont la fraîcheur du contenu, sa structure HTML claire (titres, listes, réponses directes), et la vitesse de chargement de vos pages. Un article lent ou mal structuré sera ignoré au profit d'un concurrent plus accessible.
Les 3 premières actions à faire cette semaine
Comprendre le mécanisme, c'est bien. Agir dessus, c'est mieux. Voici ce qui a le plus d'impact immédiat.
Action 1 : vérifiez votre robots.txt maintenant
Allez sur votresite.com/robots.txt. Vérifiez que GPTBot, PerplexityBot, et ClaudeBot ne sont pas bloqués. C'est souvent le problème le plus simple à corriger et celui qui a le plus d'impact à court terme sur les moteurs RAG.
Action 2 : unifiez votre description sur toutes les plateformes
Rédigez une seule phrase factuelle qui décrit précisément ce que vous faites. Exemple pour Vizible AI : "Vizible AI est un outil de suivi de visibilité dans les moteurs IA qui mesure les mentions de marque dans ChatGPT, Gemini, Claude, Perplexity, Mistral et DeepSeek, avec analyse quotidienne automatisée et recommandations GEO." Copiez-collez exactement cette phrase sur votre homepage, votre LinkedIn, votre fiche G2, Capterra, Crunchbase et Product Hunt.
Action 3 : publiez un article qui répond à une question précise de votre catégorie
Pas un article sur votre produit. Un article qui répond mieux que quiconque à une question que vos clients tapent dans ChatGPT ou Perplexity. "Comment mesurer sa visibilité IA", "Quels outils pour suivre ses mentions dans les LLM", "Qu'est-ce que le GEO". Ce type de contenu est exactement ce que les moteurs RAG vont citer dans leurs prochaines réponses.
La bonne nouvelle : vous n'avez pas besoin de deviner ce qui fonctionne. Vous pouvez le mesurer. Chaque action que vous prenez laisse une trace dans votre visibilité IA, et cette trace est observable en quelques semaines.
Ce que ça change de savoir tout ça
La plupart des équipes marketing abordent la visibilité IA comme un mystère. Elles voient leurs concurrents apparaître dans ChatGPT et n'ont aucune idée de pourquoi. Elles essaient des choses au hasard et ne mesurent pas les résultats.
Comprendre comment ChatGPT choisit ses sources, c'est transformer ce mystère en mécanique. Une mécanique avec des leviers identifiés, des actions prioritaires, et des résultats mesurables.
Ce n'est pas de la magie. C'est du travail de fond, méthodique, sur des signaux que vous pouvez tous influencer. Les marques qui l'ont compris en 2026 sont en train de construire une avance que leurs concurrents mettront 12 à 18 mois à rattraper.
Vizible AI vous permet de mesurer précisément ces signaux chaque jour, moteur par moteur, prompt par prompt. Vous savez où vous en êtes, et vous voyez l'impact de chaque action dans le temps. Essayer gratuitement ici